




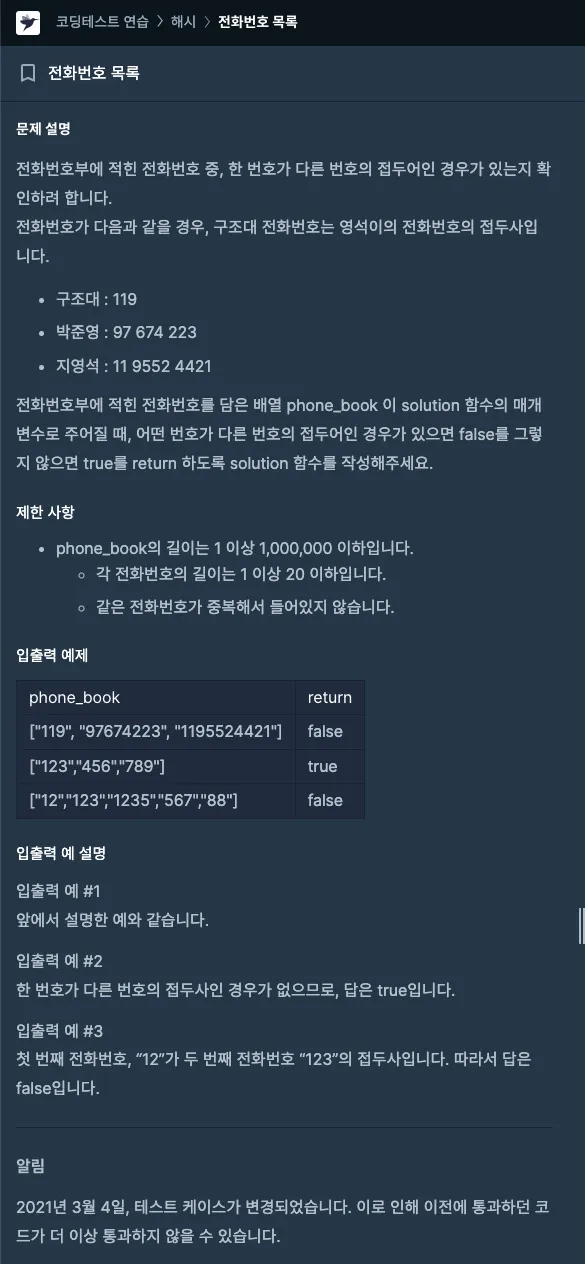

문제 해석
우선 문제를 보고 곧바로 이해가 되지않았다.
문제를 오해했던 이유는 문제에 제공된 첫 예시 구조대, 박준영, 지영석 연락처가 고정되어 주어져있고,
앞으로 입력되는 값들이 저 주어진 번호에 접두사에 포함된것인지를 확인하는 것인줄 착각했다.
알고보니 번호들을 입력하게 될 것이며, 그 번호들간의 검색을 통해서 서로 접두어가 포함된 것이 있는지 알아보라는 문제였다..
뭔가 부족한 설명이 착각하게 만든문제
기본 풀이
우선 단순하게 접근해보았다.
1,2,13이 있을때 13에는 1이 포함되어있다. 이러면 걸리는것 false가 반환
1,2,3이 있을땐 서로 겹치는게 없다. 이러면 안걸리는것 true가 반환
하지만 2중 for loop를 쓰면 1,2/1,3/2,1/2,3/3,1/3,2 를 모두 검사했을 것이다. 이러면 시간 복잡도: O(N^2)로 성능이 나타난다.
여기서 다른 풀이를 통해 힌트를 얻었다 정렬이 필요했던 것이다. Arrays.sort(phone_book);
간단히 하기 위해서 정렬+startsWith()를 통해 검색하게 되었다. 그럼 1개의 for loop만으로도 찾아낼 수 있다.
import java.util.Arrays;
// 기본 for loop 풀이.
public class Solution {
public boolean solution(String[] phone_book){
// 참고에서 추가한 정렬
Arrays.sort(phone_book);
for(int i = 0; i < phone_book.length - 1; i++){
if(phone_book[i+1].startsWith(phone_book[i])){
return false;
}
}
return true;
}
public static void main(String[] args) {
Solution sol = new Solution();
String a = "119";
String b = "97674223";
String c = "1195524421";
String[] phone_book = {a,b,c};
System.out.println(sol.solution(phone_book));
}
}
Java
복사
이를 통해 119, 97674223, 1195524421 순서였던 배열은 119, 1195524421, 97674223 로 변경된다.
i=0일때 1195524421에는 119를 포함하기 때문에 바로 return false로 빠져나가고 이대로 false가 반환된다.
그럼 왜 정렬을 해야하는가? 궁금증
•
이 코드가 두개의 값을 비교하는 원리 자체가 “유사한 값이 있는지” 를 찾는 것이 목적이기 때문에 "사전 순 정리"가 먼저 필요했던 것이다.
•
“사전 순 정리”를 통해 정렬된 배열을 사용해야 하는 이유가 또있다.
◦
이진 탐색(Binary Search) 같은 효율적인 검색 알고리즘을 활용할 수 있게 된다.
◦
정렬된 상태에서는 특정 값의 존재 여부를 더 빠르게 판단할 수 있어서 검색에 대한 성능이 향상되는 효과가 있다.
컬렉션 해시맵(HashMap)을 사용한 경우?
해시맵은 Key, Value 쌍으로 이루어진 자료구조이다. 순서가 보장되지 않으며 key로 값을 찾아내기 때문에 검색에 좋은 성능을 보여주는 것으로 알고 있다.

각 전화번호를 해시맵에 저장하고, 배열에서 하나씩 추출한 전화번호의 접두어가 해시맵에 존재하는지 여부를 확인하는 방식으로 검색하게 된다.
사실 일치되는 부분이 있는지 알 수 있는 containsKey()메소드를 통해서 찾아내게 된다.
import java.util.HashMap;
public class Solution2 {
public boolean solution(String[] phone_book) {
// 해시맵 객체 생성
HashMap<String, Integer> map = new HashMap<>();
// 해시맵에 전화번호들을 해시맵은 put으로 저장
for (String phoneNum : phone_book) {
map.put(phoneNum, 1);
}
// 각 전화번호에 대해 접두어인 경우가 있는지 확인
for (String phoneNum : phone_book) {
for (int i = 1; i < phoneNum.length(); i++) {
String prefix = phoneNum.substring(0, i);
if (map.containsKey(prefix)) {
return false;
}
}
}
return true;
}
public static void main(String[] args) {
Solution sol = new Solution();
String a = "44";
String b = "123";
String c = "1235";
String[] phone_book = {a, b, c};
System.out.println(sol.solution(phone_book));
}
}
Java
복사
하지만 궁금한것은 맵 자체는 검사를 진행하기 위해서 "단순 복제" 된 케이스이다. 불필요한 추가 코드, 복제로 보여질수도있지만 성능적 측면을 고려해서 사용되어야 할 것 같은 느낌이 들었다.
각 전화번호에 대해 모든 접두어를 해시맵에 저장하므로 O(N * M)의 시간 복잡도를 가진다.
종합
•
기본 for loop를 사용한 배열 검사:
시간 복잡도: O(N^2)
각 전화번호에 대해 모든 접두어를 검사하므로, 중첩된 루프 때문에 O(N^2)의 시간 복잡도
•
Arrays.sort를 사용한 정렬된 배열 검사:
시간 복잡도: O(N log N)
먼저 전화번호 배열을 정렬하므로 O(N log N)의 시간
이후에는 정렬된 배열에서 이진 탐색을 사용하여 중복된 접두어를 검사하므로 O(N log N)의 시간
•
해시맵을 사용한 방법:
시간 복잡도: O(N * M)
각 전화번호에 대해 모든 접두어를 해시맵에 저장하므로 O(N * M)의 시간 복잡도
여기서 M은 전화번호의 평균 길이
종합적으로, 각 방법의 성능은 입력 데이터의 크기와 특성에 따라 다르며 일반적으로는 Arrays.sort를 사용한 정렬된 배열 검사가 가장 효율적일 수 있다.